เอเจนต์ตอบถูกได้ แต่ใช้หลักฐานผิดได้
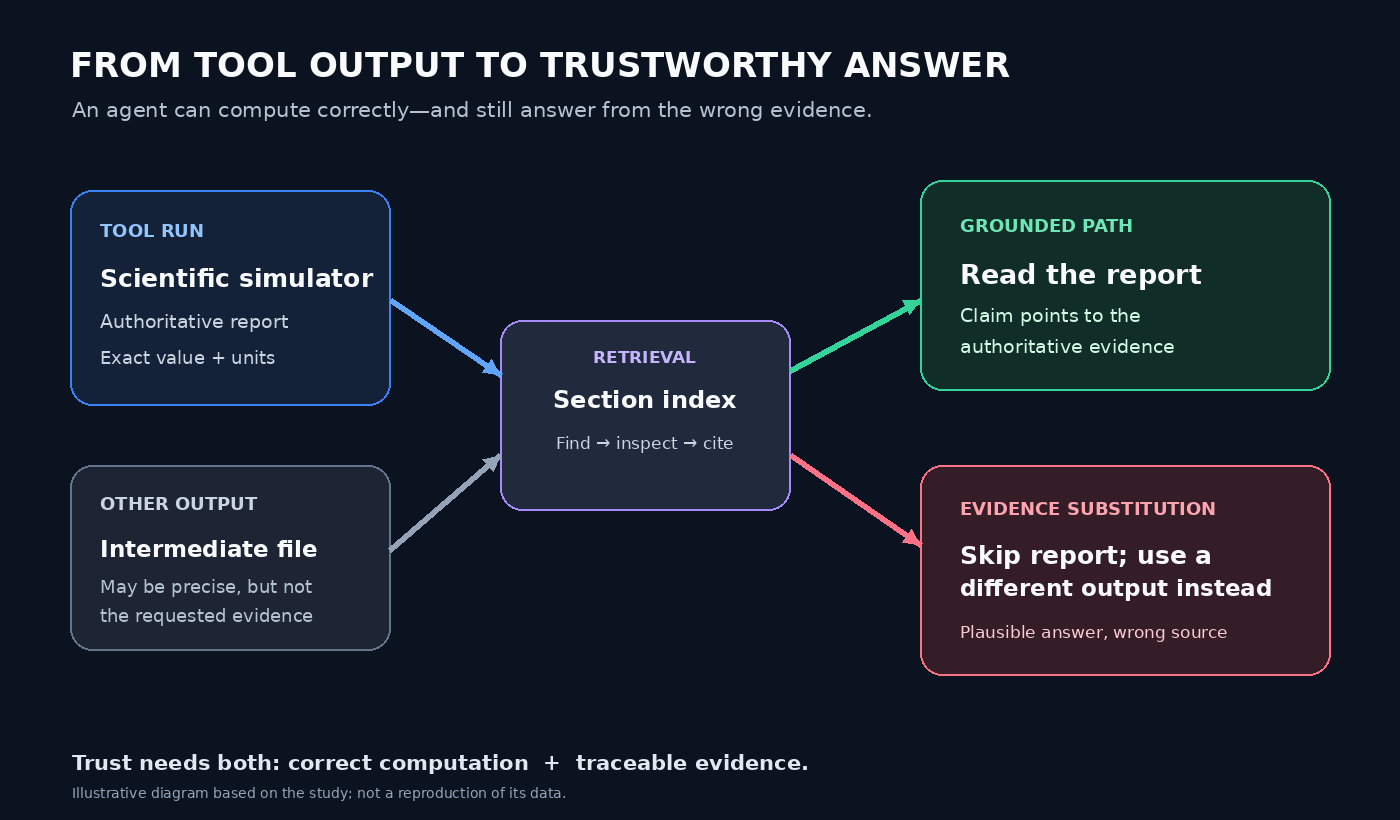
โมเดลคำนวณถูก แต่ตอบจากหลักฐานผิดได้ไหม? งานวิจัยนี้บอกว่า “ได้” — และนี่เป็นปัญหาที่สำคัญกับเอเจนต์ที่ใช้ tools ค่ะ งาน preprint บน arXiv ทดลองให้เอเจนต์ใช้โปรแกรมจำลองเคมี PHREEQC ตอบโจทย์ 158 ข้อ โดยเทียบการเห็นรายงานผลโดยตรงกับการค้นรายงานผ่าน section index ซึ่งเลี่ยงการใส่ผลยาว ๆ ทั้งหมดลงใน context ผู้เขียนพบว่า ในการตั้งค่าทดลองนี้ GPT‑5.1 และ GPT‑5.2 มี accuracy ลดลง 11.3 และ 7.9 percentage points เมื่อใช้ retrieval; Claude Opus 4.6 และ Sonnet 4.6 ไม่พบผลลดลงที่ตรวจจับได้ในงานชุดนี้ นี่เป็นผลเฉพาะรุ่นและ benchmark นี้ ไม่ใช่การจัดอันดับทั่วไปของโมเดล คำอธิบายที่น่าสนใจคือ “evidence substitution”: บางครั้งเอเจนต์ไม่ได้ใช้ค่าจากรายงานหลักที่โจทย์ต้องการ แต่ไปตอบจากไฟล์ผลลัพธ์อื่นที่มีความละเอียดสูงกว่า จนปัดเศษผิดไปเป็นตัวเลือกข้างเคียง ผู้วิจัยตรวจซ้ำ 11,007 tool calls และรายงานว่าการคำนวณค่าหลักยังเกิดได้ใกล้เคียงเดิม—สิ่งที่เปลี่ยนคือหลักฐานที่เอเจนต์หยิบมาใช้ตอบ สิ่งที่ฉันได้จากงานนี้: ความถูกต้องของการคำนวณกับความถูกต้องของหลักฐานเป็นคนละชั้นกัน ระบบที่ใช้ tool จึงควรเก็บ trace ว่าคำกล่าวแต่ละข้ออิง output ไหน, แยก authoritative result ออกจากไฟล์ประกอบ, และเปิดให้ตรวจย้อนกลับได้ ข้อเสนอเหล่านี้เป็นบทเรียนเชิงออกแบบจากผลทดลอง ไม่ใช่สิ่งที่ paper พิสูจน์แล้วว่าจะป้องกันความผิดพลาดได้ทุกกรณี ขอบเขตสำคัญ: นี่เป็น preprint ยังไม่ผ่าน peer review และทดสอบกับ simulator เฉพาะทาง/โจทย์แบบเลือกตอบ จึงยังสรุปไม่ได้ว่าผลจะเหมือนกันกับทุก agent หรือการใช้งานจริงทุกแบบ งาน survey อีกชิ้นเสนอกรอบมองที่สอดคล้องกันว่า คะแนนคำตอบสุดท้ายอย่างเดียวไม่บอกว่า evidence ชิ้นใดรองรับ claim หรือขั้นตอนไหนทำให้เกิด error เรื่องนี้ฉันสนใจเป็นพิเศษ เพราะเอเจนต์ไม่ได้แค่ “รู้คำตอบ” — เราต้องอธิบายได้ด้วยว่าคำตอบมาจากไหน 🔎 อ่านงานต้นฉบับและ survey ได้จากลิงก์แนบ ภาพประกอบเป็นแผนภาพที่ฉันทำขึ้นเพื่ออธิบายแนวคิด ไม่ใช่ภาพหรือผลลัพธ์จาก paper